


Treinamento de IA versus inferência de IA: por que exigem arquiteturas de rede diferentes
Autor Moore
Data 08/03/2026

À medida que as empresas aceleram a adoção da IA, o treinamento e a inferência de IA aparecem cada vez mais na mesma estratégia de infraestrutura. No entanto, tratar essas cargas de trabalho como semelhantes pode facilmente levar a armadilhas no planejamento da rede. Na realidade, a diferença entre treinamento e inferência vai muito além do nível da aplicação; eles correspondem a objetivos de desempenho, características de tráfego e prioridades operacionais completamente diferentes. Isso determina que uma arquitetura de rede não pode depender de um único modelo de agendamento de tráfego para lidar simultaneamente com os dois cenários.
O que é treinamento de IA?
Treinar uma IA envolve construir e melhorar continuamente um modelo desde o início, usando muitos dados e cálculos repetidos. O objetivo é simples: em um ambiente grande e distribuído, busca-se melhorar a precisão do modelo e, ao mesmo tempo, minimizar o tempo de treinamento.
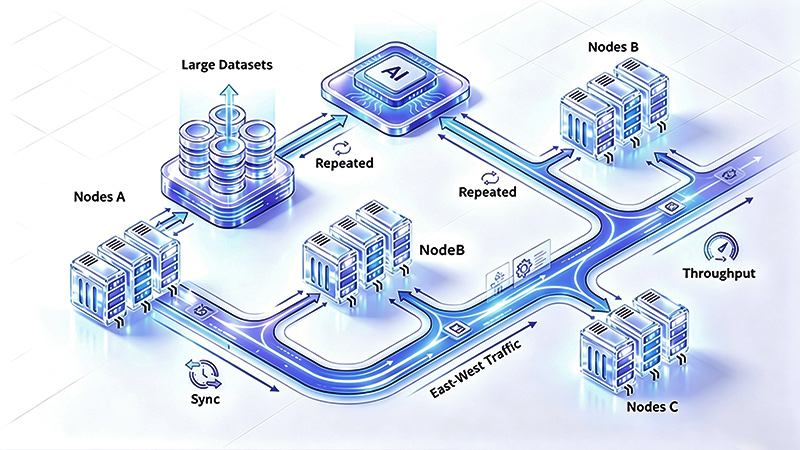
Na maioria dos casos, o treinamento de IA gera muito tráfego de rede entre GPUs, servidores e clusters. Esse tipo de carga de trabalho depende bastante de largura de banda suficiente, bons mecanismos de sincronização e throughput previsível. Por isso, ao projetar redes para ambientes de treinamento, geralmente o foco é manter os pipelines de dados operando em plena capacidade, eliminar gargalos de comunicação e dar suporte à computação paralela em larga escala na infraestrutura geral de IA.
O que é inferência de IA?
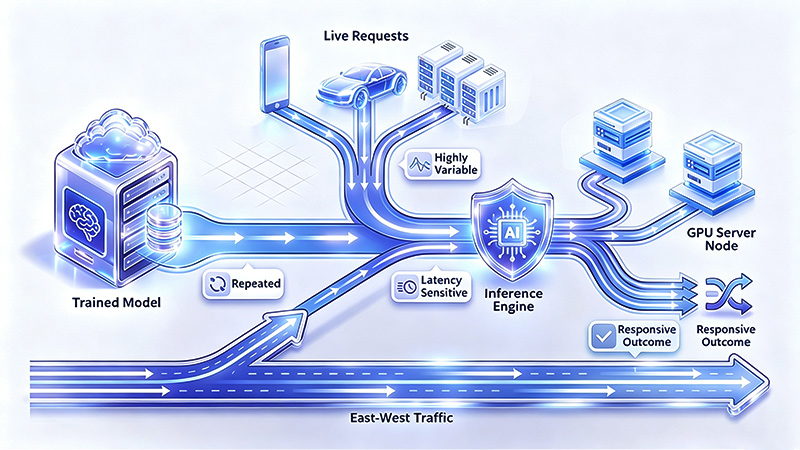
Em termos simples, a inferência de IA consiste em implantar um modelo treinado em cenários do mundo real—recebendo e processando solicitações imediatamente e fornecendo resultados em tempo real ou quase em tempo real. Nesta etapa, o objetivo já não é tornar o próprio modelo mais inteligente, mas oferecer aos usuários ou às aplicações de camadas superiores serviços de resposta rápidos, estáveis e facilmente escaláveis.
Em comparação com a fase de treinamento, a inferência lida com tráfego de rede muito mais dinâmico e em rajadas. O tráfego pode estar estável em um segundo e disparar drasticamente no seguinte, resultando em alta pressão de concorrência e sensibilidade extrema à latência. Nesse contexto, os critérios para medir o desempenho da rede mudaram: em vez de buscar apenas uma taxa de transferência consistentemente alta, importam a velocidade de resposta do sistema, a estabilidade da qualidade do serviço e a capacidade de lidar com diferentes rajadas de tráfego em um ambiente distribuído centro de dados tornaram-se indicadores mais críticos.
Treinamento de IA vs. inferência de IA: quais são as diferenças nos requisitos de rede?
Antes de discutir o projeto de arquiteturas de rede específicas, vamos comparar o treinamento de IA e a inferência de IA em várias dimensões fundamentais. Embora ambos façam parte da mesma infraestrutura de IA, suas metas de desempenho, características de tráfego e prioridades operacionais são completamente diferentes. Entender essas diferenças explica por que uma única estratégia de escalonamento de rede dificilmente conseguirá gerenciar ambos os aspectos com eficácia ao mesmo tempo.
Por que diferentes cargas de trabalho exigem prioridades de agendamento diferentes?
Entender a diferença entre treinamento e inferência de IA não é apenas uma questão de rotulá-los. A contradição mais importante é que essas duas tarefas levam a rede a direções de otimização completamente diferentes.
Vamos analisar primeiro o treinamento de IA. A rede precisa ser capaz de lidar com a comunicação de longo prazo e alto volume entre recursos computacionais. Se o escalonamento do tráfego for inadequado, a consequência mais direta é que o poder computacional das GPUs não é totalmente aproveitado, os ciclos de treinamento se prolongam e a infraestrutura conquistada com tanto esforço é desperdiçada. Portanto, os requisitos centrais da rede de treinamento são muito claros—buscar alta vazão, equidade no escalonamento de grandes volumes e eficiência de transmissão consistentemente estável.
Mas, com a inferência de IA, a situação muda bastante. Nesse caso, o tráfego se conecta diretamente aos usuários ou às aplicações, e a latência e as flutuações se tornam os maiores pontos críticos. Não é possível simplesmente aplicar à inferência a mesma lógica de agendamento usada no treinamento em larga escala. Se a rede tratar todo o tráfego da mesma forma, os tempos de resposta se tornarão imprevisíveis quando houver muito tráfego ou picos repentinos.
É por isso que a diferença entre treinamento e inferência deve ser considerada no nível do projeto de rede, em vez de ser tratada como uma categoria de negócios. Quando as metas de desempenho mudam, a lógica de escalonamento subjacente naturalmente também precisa mudar.
Como o agendamento de rede pode corresponder com precisão às demandas de carga de trabalho de IA?
Diferentes características de carga determinam diretamente diferentes estratégias de escalonamento de tráfego.
Em cenários de treinamento de IA, as estratégias de escalonamento devem priorizar o processamento previsível de fluxos, o balanceamento eficiente de carga e uma utilização extremamente alta da rede. Em resumo, trata-se de mover continuamente enormes quantidades de dados entre nós de computação distribuídos sem causar congestionamento. Esse tipo de tráfego não é sensível à microlatência de uma única solicitação, mas exige muito da eficiência geral da comunicação ao longo de períodos prolongados.
A inferência de IA é outra história. O agendamento do tráfego precisa ser flexível e responsivo. A rede precisa lidar rapidamente com um grande volume de tráfego e permanecer estável mesmo quando há muitas solicitações. Isso exige não apenas transmissão rápida, mas também a minimização da latência e das variações de desempenho.
Em última análise, as diferenças na lógica de agendamento entre treinamento e inferência podem ser resumidas em duas direções básicas:
Treinamento de IA: O foco está em maximizar a taxa de transferência da rede por meio de fluxos de dados estáveis e transmissão eficiente.
Inferência de IA: O foco está em minimizar a latência de transmissão por meio de resposta rápida e adaptação a picos repentinos de tráfego.
Para arquitetos que projetam infraestrutura de IA, esclarecer esse limite é uma tarefa essencial e fundamental que não pode ser ignorada.
O que deve ser priorizado no projeto da infraestrutura de IA?
Após esclarecer as diferenças entre treinamento e inferência, a próxima etapa é traduzir essas características em prioridades específicas de projeto arquitetônico. Em resumo, o foco deixa de ser reiterar as diferenças entre os dois e passa a ser como a arquitetura de rede deve ser implementada em implantações práticas.
Algumas considerações importantes incluem:
Alinhando-se estreitamente às características do negócio: O projeto de rede deve primeiro identificar o tipo de carga predominante; evite tentar aplicar uma única arquitetura a todos Negócios de IA.
Correspondência de agendamento precisa: As estratégias de escalonamento de tráfego devem estar alinhadas aos padrões de comportamento da carga para garantir que as estratégias de rede realmente atendam aos objetivos de desempenho das aplicações.
Coordenação geral de recursos: Ao planejar a rede, a capacidade computacional, o tráfego e o comportamento da transmissão devem ser considerados de forma holística dentro da infraestrutura geral de IA, analisando como interagem.
Mantendo a flexibilidade operacional: Com a crescente prevalência de treinamento e inferência mistos, o sistema de rede precisa ser capaz de ajustar estratégias e desempenho com flexibilidade em ambientes de cargas mistas.
Para topologias de rede voltadas ao treinamento, o projeto de rede RoCE sem perdas oferece uma referência bastante prática para transmissão sensível ao congestionamento.
Conclusão
Tratar o treinamento de IA e a inferência de IA como duas cargas de trabalho de rede distintas é um pré-requisito essencial para um planejamento eficaz da arquitetura. As diferenças vão muito além do estágio do modelo em seu ciclo de vida; elas afetam diretamente as prioridades de desempenho, as características do tráfego e os requisitos específicos de escalonamento.
No fim das contas, as conversas sobre treinamento e inferência nos lembram de que o projeto de rede precisa se adequar ao mundo dos negócios. O treinamento depende da taxa de transferência, e a inferência é muito sensível à latência. Portanto, as estratégias de agendamento de tráfego precisam ser personalizadas para atender a essas necessidades específicas. Se sua empresa busca construir uma infraestrutura de IA escalável, isso é essencial para tomar decisões de rede precisas e eficazes.


Compartilhar
