


Desbloqueando o XDR 1.6T: o novo pilar da supercomputação de IA de próxima geração
Autor Moore
Data 08/28/2026

À medida que o treinamento de IA em larga escala e os modelos com trilhões de parâmetros se tornam a norma, os gargalos de desempenho na infraestrutura de IA estão migrando—da capacidade computacional pura para a interconectividade de rede. Embora as GPUs estejam evoluindo rapidamente, o enorme tráfego leste-oeste gerado pelo treinamento distribuído está crescendo ainda mais rápido. Como resultado, a largura de banda, a latência e a escalabilidade da rede se tornaram os principais fatores que determinam a utilização geral dos recursos computacionais de todo o cluster.
A tecnologia de rede evoluiu de HDR 200G para NDR 400G e 800G, e hoje os contornos da próxima geração já estão bastante claros: uma arquitetura de interconexão de 1.6T baseada em tecnologia de sinal de 200G por canal está no centro das atenções. Combinando fotônica de silício, DSPs avançados e tecnologia de interconexão óptica de alta densidade, o InfiniBand XDR 1.6T está prestes a desempenhar um papel central no suporte a futuros clusters de supercomputação de IA.
Os clusters de IA estão impulsionando a evolução das redes de 800G NDR para 1.6T XDR
Desafios de rede enfrentados por clusters de IA em hiperescala
Hoje’ o treinamento distribuído de IA frequentemente exige que milhares ou até dezenas de milhares de GPUs trabalhem em conjunto. A sincronização em larga escala de parâmetros, a agregação de gradientes e a comunicação frequente entre clusters geram um enorme volume de tráfego de rede leste-oeste nos data centers.
À medida que os tamanhos dos clusters continuam a crescer, as redes HDR e NDR existentes começam a apresentar gargalos, principalmente nas seguintes áreas:
Limitações de largura de banda: diante das demandas de comunicação de alta velocidade de grandes conjuntos de GPUs, os links de 400G já têm dificuldade para acompanhar, o que pode levar à ociosidade dos recursos computacionais e à redução da utilização geral.
Limitações da distância de transmissão: as soluções ópticas SR multimodo tradicionais têm distâncias de cobertura relativamente curtas, o que limita diretamente a flexibilidade dos data centers em hiperescala no layout dos racks e no planejamento espacial.
Os dois desafios do consumo de energia e da integridade do sinal: aumentar a taxa do sinal elétrico para elevar a taxa de transferência leva a um forte aumento do consumo de energia e impõe uma pressão significativa sobre o gerenciamento térmico, além de representar sérios desafios para o controle da taxa de erro de bit (BER).
As redes InfiniBand vêm melhorando e ficando mais rápidas nos últimos 20 anos para lidar com esse tipo de problema. A cada transição de geração, elas alcançaram grandes avanços na taxa de transferência, introduzindo continuamente tecnologias SerDes mais rápidas e arquiteturas de interconexão subjacentes de maior desempenho.
Parâmetros básicos da tecnologia central padrão do setor 1.6T XDR
O cerne desse salto geracional está na atualização abrangente dos sinais elétricos de SerDes de 100G para 200G. Ao duplicar a largura de banda por canal—combinada com a tecnologia DSP avançada e uma arquitetura de encapsulamento aprimorada—a plataforma XDR de nova geração pode elevar significativamente o limite máximo da taxa de transferência geral da rede sem aumentar significativamente a complexidade do sistema.
Principais tecnologias subjacentes que dão suporte ao XDR de 1.6T
Apenas aumentar a largura de banda não é suficiente. Para Interconexões de 1.6T para que funcionem de verdade, eles precisam evoluir juntos em várias áreas, como encapsulamento óptico, processamento de sinais DSP, projeto de gerenciamento térmico e chips de switch de baixo nível, entre outras.
Uma análise aprofundada da arquitetura de hardware full-stack: 1.6T XDR vs. 800G NDR
Para construir uma rede de IA de alto desempenho, simplesmente atualizar os chips dos switches está longe de ser suficiente. Toda a infraestrutura de interconexão deve contar com o trabalho coordenado de módulos ópticos, cabos de cobre DAC de conexão direta, cabos ópticos ativos AOC e componentes de interconexão em ramificação para atender aos requisitos rigorosos em diferentes distâncias de transmissão.
Das GPUs dentro do rack às interconexões entre switches e, depois, aos enlaces de backbone de longo alcance que conectam diferentes data centers, cada componente desempenha um papel indispensável no suporte a uma rede altamente escalável.
Matriz de produtos de módulos ópticos: de 800G NDR a 1.6T com fotônica de silício
Para conexões de média e longa distância em data centers de IA, os módulos ópticos continuam sendo a solução preferida. Dependendo da distância que o sinal precisa percorrer e do tipo de fibra, o setor geralmente os classifica em três categorias: soluções multimodo SR (curto alcance), soluções monomodo DR (classe de data center) e soluções monomodo FR (longo alcance).
À medida que as taxas de dados se aproximam de 1.6T, a tecnologia de fotônica de silício (SiPh) está se tornando cada vez mais importante. Integrar funções ópticas diretamente a uma plataforma baseada em silício é um divisor de águas para a fotônica de silício. Ela oferece muitas vantagens.
Maior densidade de integração
Menor consumo de energia
Melhor escalabilidade para produção em massa
Mais flexibilidade para o gerenciamento térmico
Graças a essas características, a tecnologia de fotônica de silício tornou-se uma das principais alternativas para a implantação futura de redes 1.6T em grande escala.
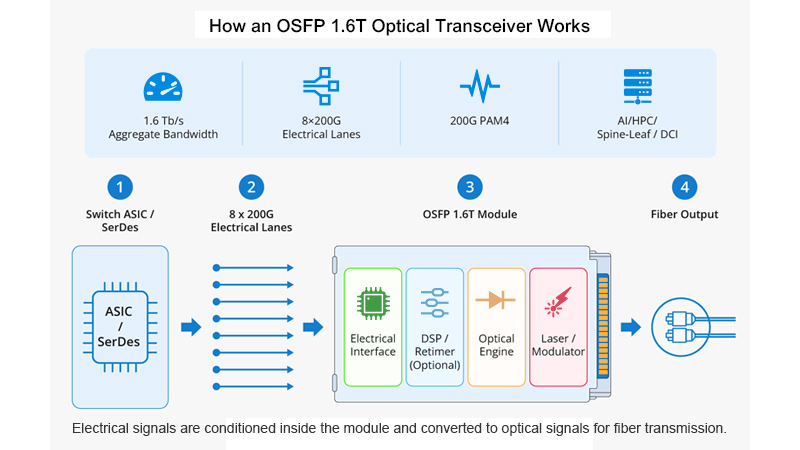
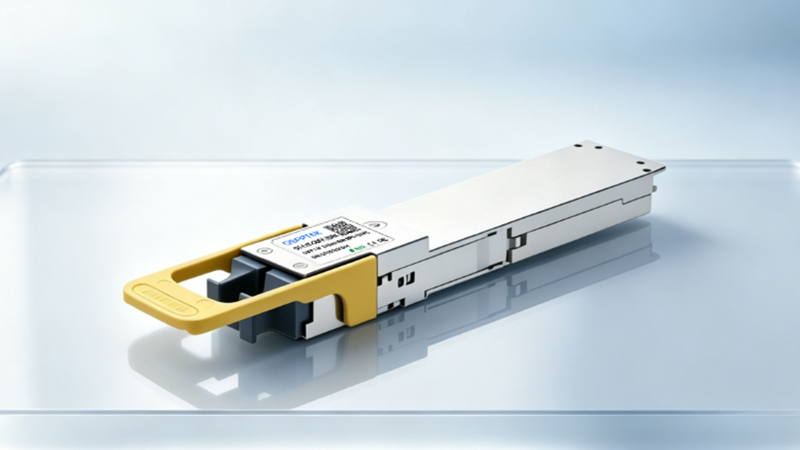
1.6T XDR OSFP DR8 (solução de fotônica de silício monomodo de 1310 nm)
O comprimento de onda de operação é 1310 nm, e ele utiliza transmissão por fibra monomodo.
A distância de transmissão típica é de até 500 metros.
Conta com um design de interface MPO dupla
Arquitetura paralela de 8 canais, com uma taxa de dados de aproximadamente 200G por canal
Aplicações típicas: interconexões de backbone entre switches de IA de próxima geração e implantação de redes fabric para clusters de IA em hiperescala.
Série OSFP 800G NDR
SR8 (850 nm multimode): utiliza fibra OM3 e OM4 para conexões de alta velocidade e curta distância dentro de data centers.
FR8 (1310 nm monomodo): pode transmitir a longas distâncias, até mesmo por vários quilômetros, permitindo conexões de longa distância entre edifícios e campus.
Série 400G NDR OSFP / QSFP56
Oferece arquiteturas comprovadas, como SR4, DR4 e FR4
Possibilita uma evolução e transição contínuas a partir de redes HDR
Amplamente implantado no lado de acesso dos servidores e em redes da camada de acesso.
Matrizes de cabos de alta velocidade: soluções de interconexão DAC e AOC
Esses cabos são usados principalmente para conectar servidores GPU e switches no mesmo rack. Alguns dos tipos mais comuns incluem cabos de cobre passivos (DAC), cabos ópticos ativos (AOC) e cabos divisores (1 para 2 ou 1 para 4). Esses cabos são populares para conexões de curta distância em clusters de IA porque são acessíveis e permitem cabeamento de alta densidade.
Cabos de cobre passivos DAC (interfaces OSFP / QSFP56): esses cabos não contêm chips de processamento de sinal em nenhuma das extremidades e dependem inteiramente do meio de cobre para a transmissão puramente elétrica do sinal, oferecendo as vantagens do consumo de energia ultrabaixo e do baixo custo. Os comprimentos comuns são principalmente de 1 metro e 3 metros, e eles são projetados especificamente para interconexões internas de racks que variam de 1 a 3 metros. Os formatos de produto incluem cabos padrão de conexão direta, divisores tipo Y de 1 para 2 e divisores de 1 para 4, que permitem a expansão flexível e econômica de nós com várias GPUs ao dividir a largura de banda de uma única porta.
Cabos AOC ativos: esses cabos integram chips de conversão optoeletrônica nas duas extremidades e usam fibra óptica para transmissão no trecho intermediário, superando completamente as limitações de distância física de transmissão dos cabos de cobre. Entre eles, o AOC HDR 200G oferece suporte a distâncias de transmissão de até 100 metros, enquanto o AOC NDR 400G pode cobrir distâncias de várias dezenas de metros; eles são usados principalmente em interconexões de alta velocidade entre racks adjacentes.
Cabos breakout: Eles oferecem suporte a especificações de conversão, como OSFP para 2×QSFP56 ou OSFP para 4×OSFP, permitindo dividir uma única porta 800G em múltiplos downlinks 200G/400G. São perfeitos para redes flexíveis em diversos clusters de IA e podem reduzir bastante o número de portas de switch ociosas e desperdiçadas.
Ao longo de três gerações: a evolução do hardware de rede
De HDR a NDR, e agora a XDR, o salto tecnológico envolvido vai muito além de simplesmente dobrar os valores de largura de banda. A cada geração, a modulação de sinal subjacente, a arquitetura DSP, os projetos de encapsulamento óptico e o consumo geral de energia passaram por uma reformulação completa.
As principais diferenças entre essas três gerações de arquiteturas de hardware se refletem sobretudo nestas métricas essenciais.
O valor prático das redes 1.6T XDR em clusters de supercomputação de IA
Aumenta significativamente a utilização da capacidade de computação de GPU
Graças à arquitetura de latência ultrabaixa que combina RDMA de 1.6T e InfiniBand, a latência de comunicação entre GPUs foi reduzida à faixa de microssegundos. No treinamento distribuído de modelos de grande porte, a utilização efetiva da capacidade computacional dos clusters de GPUs pode saltar diretamente de aproximadamente 40% para 75%–80%, reduzindo substancialmente o ciclo de treinamento de modelos com trilhões de parâmetros. Se os clusters 800G NDR existentes forem atualizados e substituídos por uma rede de backbone XDR, espera-se que a eficiência geral de treinamento de todo o cluster aumente em mais de 40%.
Otimizando os custos de cabeamento e infraestrutura do data center
Redução do número total de portas de switch: com o dobro da largura de banda por porta, o número de portas necessárias em um switch é reduzido em 50%, mantendo a mesma capacidade de computação e reduzindo significativamente o espaço ocupado no rack, as cargas de distribuição de energia e os custos de refrigeração.
Maior distância de transmissão: Os módulos da série DR/FR monomodo de 1310nm oferecem suporte a distâncias de transmissão de 500 metros a 2 quilômetros. Isso supera as limitações de distância impostas pela fibra multimodo de 850nm nos layouts físicos dos data centers. Assim, fica mais fácil redistribuir os racks e adicionar mais capacidade em centros de computação inteligente.
Eficiência energética superior em todo o enlace: A integração da fotônica de silício com uma solução DSP de última geração de 3nm reduz o consumo de energia por Gbps de largura de banda em cerca de 25% em comparação com componentes discretos convencionais. Isso reduz significativamente os custos de eletricidade de clusters de supercomputação que utilizam 10,000 placas e operam com alta carga durante todo o ano.
Compatível com os ativos de rede existentes
O protocolo XDR 1.6T funciona com NDR 800G e HDR 200G. Você não precisa reconstruir completamente seus clusters de 200G/400G. Basta substituir os switches principais e os módulos ópticos do backbone para fazer a transição gradual para 1.6T. Isso realmente reduzirá bastante os custos iniciais de atualização.
Recomendações de seleção para cenários comuns
Diferentes cenários de negócios têm diferentes requisitos de interconexão. Ao escolher o hardware, normalmente você considera fatores como a distância que o sinal precisa percorrer, a quantidade de cabeamento necessária, quanto pretende gastar e se precisará expandir no futuro.
Com base nas necessidades reais dos ambientes empresariais predominantes, as soluções de hardware de rede recomendadas para diferentes cenários são resumidas a seguir:
Conclusão
Considerando as tendências tecnológicas gerais do setor, a adoção da fotônica de silício continua a acelerar. À medida que as velocidades de rede ultrapassam o limiar de 800G, o valor da fotônica de silício na redução do consumo de energia e no aumento da integração torna-se insubstituível; ao mesmo tempo, as redes 1.6T estão passando do planejamento voltado ao futuro para uma implantação comercial efetiva e se tornarão a base do treinamento de IA de alta largura de banda nos próximos anos. Quanto às soluções de longo prazo, como a óptica coencapsulada (CPO), o entusiasmo por R&D continua alto. Tanto agora quanto no futuro previsível, os módulos ópticos conectáveis maduros serão amplamente predominantes nas implantações.
Isso também significa que 1.6T representa a etapa-chave mais clara e pragmática na atualização atual da infraestrutura de IA. No entanto, para que a arquitetura de 1.6T funcione de fato, simplesmente atualizar o hardware dos switches está longe de ser suficiente; são necessários os esforços coordenados de todo um ecossistema de interconexão que abrange módulos ópticos, cabos de alta velocidade e arquitetura de rede.
Com um portfólio completo de produtos que abrange 400G, 800G e o emergente 1.6T—incluindo módulos transceptores baseados em fotônica de silício, conjuntos de cabos DAC/AOC de alta densidade e soluções de rede voltadas para IA— a QSFPTEK está comprometida em ajudar os usuários a criar uma infraestrutura de computação altamente escalável e de alto desempenho, garantindo uma transição mais estável e integrada da arquitetura NDR existente para a próxima geração de AI Fabric 1.6T.


Compartilhar
