


Evolução da arquitetura de computação de IA: Scale-Up vs. Scale-Out e a escolha de módulos ópticos
Autor Moore
Data 04/02/2026

À medida que modelos de larga escala alcançam trilhões de parâmetros e o tamanho dos clusters de IA se aproxima de centenas de milhares de GPUs, a infraestrutura computacional subjacente passa por uma mudança arquitetural significativa. Os dois modelos de rede predominantes para computação de IA—Scale-Up e Scale-Out—avançam por diferentes caminhos técnicos, mas, na prática, estão convergindo gradualmente em pontos-chave.
Essa mudança é essencialmente o resultado de concessões repetidas entre "baixa latência e alta escalabilidade" e "alta confiabilidade e controle de custos". Ao mesmo tempo, a evolução contínua das tecnologias de módulos ópticos (como LPO, NPO e CPO) está moldando cada vez mais o design do sistema.
Scale-Up vs. Scale-Out: diferenciação e trade-offs entre dois caminhos
No projeto de clusters de computação de IA, Scale-Up e Scale-Out têm objetivos diferentes desde o início, e seus critérios de avaliação não estão alinhados na mesma dimensão. Eles podem ser entendidos como duas abordagens divergentes.
Scale-Up: Arquitetura fortemente acoplada com ênfase em baixa latência e consistência forte
Scale-up está mais próximo de estender o poder computacional de um único nó; essencialmente, trata-se de "integração horizontal" dentro da arquitetura de GPU existente. Ao construir unidades de computação altamente acopladas, a memória local de várias GPUs é abstraída em um espaço lógico unificado, permitindo que o núcleo de computação experimente HBM quase local ao acessar memória remota. Essa abordagem de semântica de proximidade da memória visa não apenas expandir a escala, mas também minimizar a distância entre computação e dados, reduzindo a latência para menos de microssegundos enquanto mantém alta consistência e estabilidade.
Scale-Out: modelo de computação distribuída orientado à escalabilidade
Em contraste, Scale-Out é mais como reunir poder computacional disperso ao organizar um grande número de nós em um todo coeso por meio de uma rede. Implementações típicas são baseadas em uma arquitetura Clos de duas ou três camadas, conectando dezenas de milhares ou até mais GPUs ao mesmo cluster de treinamento para oferecer suporte a paralelismo de dados, paralelismo em pipeline e outros modos de treinamento. Essa abordagem se concentra em escalabilidade e controle de custos, garantindo que o sistema esteja sempre disponível e possa crescer para atender às suas necessidades enquanto trabalha com seu hardware e software atuais.
Em geral, Scale-Up trata de melhorar as "capacidades individuais" para alcançar desempenho máximo e baixa latência. Por outro lado, Scale-Out trata principalmente de "eficiência de escala", o que permite que clusters de grande escala funcionem sem problemas. O primeiro se concentra nas unidades centrais da computação de alto desempenho, enquanto o segundo forma a rede fundamental para treinamento e inferência em larga escala. Esses dois modos frequentemente coexistem e se complementam na infraestrutura de IA do mundo real.
Evolução Atual: Mudanças na Arquitetura Scale-Up e Tendências de Simplificação Scale-Out
Nos últimos anos, Scale-Up e Scale-Out vêm evoluindo rapidamente, e os principais fabricantes descobriram como implementá-los na prática. O objetivo é aumentar o desempenho e, ao mesmo tempo, simplificar a complexidade.
Scale-Up: De Baseado em Chassi à Coexistência Multiformato, a Interconexão 224G Torna-se um Nó-chave
As primeiras soluções para empresas em crescimento concentravam-se principalmente em "chassis SuperNodes", que reuniam recursos de computação em um único sistema e os conectavam por meio de links de alta velocidade. Essas soluções enfatizavam estabilidade e consistência, normalmente empregando uma combinação de "backplane de cabos + comutação L1/L2": as interconexões internas do chassi dependiam principalmente de conexões elétricas para garantir alta densidade de largura de banda; a expansão entre chassis dependia de interconexões ópticas.
As interconexões ópticas 224G estão gradualmente se tornando a escolha principal para cenários de scale-up. Do ponto de vista de um modelo de custo, o preço de módulos ópticos 1.6T provavelmente permanecerá aproximadamente de 1.2 a 1.4 vezes o de 800G nos próximos três a cinco anos. Essa diferença é bastante fácil de lidar, seja com base em LPO ou na arquitetura DSP tradicional. Mas usar tecnologia 112G muitas vezes significa usar mais fibra para a mesma largura de banda, o que acaba custando mais. Ao considerar fatores como largura de banda, consumo de energia e complexidade do cabeamento, a solução 224G é melhor a longo prazo.
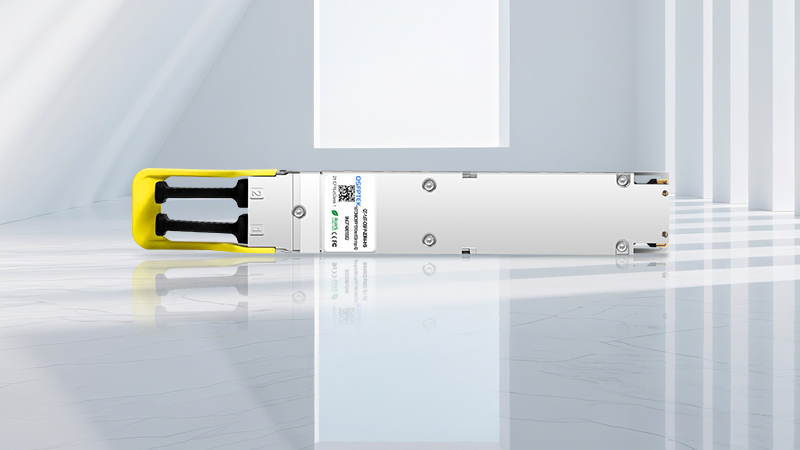
Módulo óptico QSFPTEK 1.6T
O setor vem acompanhando essa tendência e começou a desenvolver produtos relacionados, como os módulos da série OSFP da QSFPTEK, que suportam taxas de 1.6T (por exemplo, especificações 2×DR4 e 2×FR4). Eles visam principalmente atender aos requisitos de alta largura de banda e baixa latência das futuras arquiteturas de supernós. Esses produtos também estão preparando os data centers para a próxima etapa de seu crescimento.
Scale-Out: De três camadas para duas camadas, a estrutura de rede se torna gradualmente mais plana
Uma mudança significativa nas arquiteturas scale-out é a ênfase crescente na simplificação do design geral. A rede Clos de três camadas, anteriormente comum, está sendo gradualmente substituída por uma arquitetura Clos de duas camadas. Ao reduzir o número de camadas intermediárias, o caminho da rede se torna mais direto, reduzindo a complexidade do sistema. Com esse design, mesmo clusters de treinamento voltados a centenas de milhares de GPUs podem manter alta escalabilidade enquanto mantêm os custos de rede sob controle.
Essa mudança se deve em grande parte a melhorias nas capacidades dos chips de comutação. À medida que os tamanhos das portas continuam aumentando, por exemplo, com Radix chegando a 512 portas, uma rede Clos de duas camadas pode oferecer suporte direto a escalas de nós acima de 100.000 e, em alguns modelos de projeto, até cobrir cerca de 130.000 placas aceleradoras, sem precisar de uma camada adicional de comutação central. Isso significa que grandes clusters de IA podem manter a densidade de largura de banda enquanto mantêm uma topologia de rede mais clara durante a expansão.
Redes Multi-Plane: Aliviando a pressão de largura de banda por meio do design Multi-Plane
Com base nessa fundação, alguns fabricantes começaram a explorar novos métodos de organização de rede. Por exemplo, a arquitetura Multi-Plane proposta em pesquisas relacionadas é uma abordagem típica. Nesse esquema, a AI-NIC acessa simultaneamente diferentes planos de rede Clos por meio de várias portas de alta velocidade; por exemplo, ela usa quatro interfaces 200G para conectar quatro planos de rede independentes e, no lado de envio, distribui o mesmo fluxo de dados entre os planos usando um método round-robin.
Na extremidade receptora, um mecanismo de processamento de dados que suporta gravações fora de ordem remonta dados de diferentes caminhos, de modo que um único link não se torne um gargalo. Essa abordagem melhora a utilização da largura de banda em uma única GPU em cenários Scale-Out, alcançando uma taxa geral de utilização superior a 95% em alguns modelos de teste.
Do ponto de vista das tendências, o foco do Scale-Out não está apenas no aumento da escala, mas em alcançar um equilíbrio mais razoável entre largura de banda, eficiência e custo em clusters de IA de ultra grande escala por meio de otimização estrutural e inovação no design de rede.
Tendências de seleção de módulos ópticos: LPO/NPO ganha popularidade, CPO declina gradualmente
Tanto nas arquiteturas Scale-Up quanto Scale-Out, os módulos ópticos não são apenas o meio de conexão, mas também afetam diretamente a latência, o consumo de energia e a estabilidade do link. Portanto, diferentes abordagens tecnológicas são cada vez mais distintas em suas escolhas quanto aos formatos de módulos ópticos. As diferenças entre LPO, NPO e soluções tradicionais habilitadas para DSP estão se tornando mais claras, enquanto a popularidade do CPO diminuiu relativamente.
Scale-Up: Soluções de menor latência preferem LPO/NPO
Em cenários em que o sistema é ampliado, o objetivo é reduzir a latência e o consumo de energia. Isso torna as soluções LPO ou NPO sem DSPs mais populares. Esses módulos ópticos tornam o caminho de processamento de sinal mais simples, o que reduz bastante a quantidade de energia que eles usam. Por exemplo, um módulo 800G com uma solução LPO consome aproximadamente 6W, uma melhoria significativa em relação aos produtos tradicionais equipados com DSP, que normalmente consomem cerca de 15W.
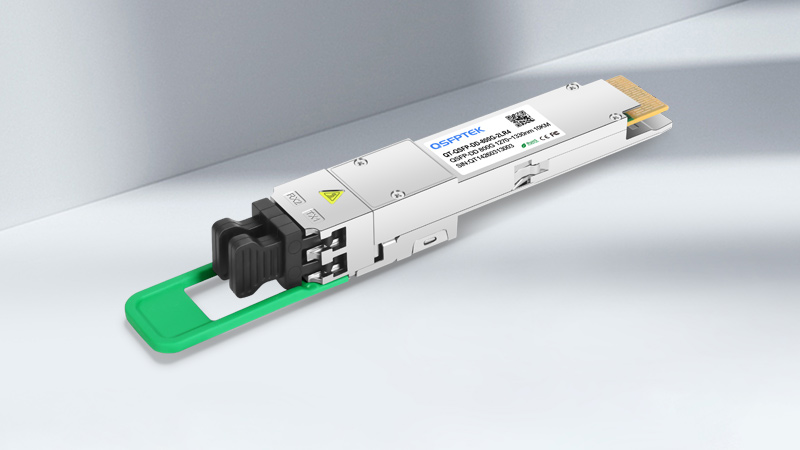
Módulo óptico QSFPTEK 800G
Simultaneamente, o envolvimento reduzido do DSP no processamento de dados também reduz a latência do link. A latência unidirecional pode ser encurtada em dezenas de nanossegundos, com uma redução ainda mais pronunciada na latência de ida e volta. Essas características os tornam mais adequados aos requisitos de scale-up de "curto alcance, alta consistência", e alguns produtos LPO otimizados para data centers de IA são projetados com base nessas métricas.
Scale-Out: a arquitetura DSP ainda é a escolha predominante
Em ambientes onde os sistemas são escalados horizontalmente, porém, a situação é completamente diferente. Módulos ópticos com processadores de sinal digital (DSPs) lidam melhor com grandes conexões de rede e longas distâncias de transmissão. Por esse motivo, eles continuam sendo a escolha preferida.
Por um lado, em termos de controle de erros, os DSPs podem oferecer suporte a mecanismos de correção antecipada de erros mais complexos, permitindo que o link alcance uma taxa de erros menor após a correção, tornando-os adequados para cenários de transmissão de longa distância. Os módulos LPO/NPO, por outro lado, têm capacidades relativamente limitadas nesse aspecto, muitas vezes não conseguindo atender aos requisitos de estabilidade para links entre data centers ou de nível de 10 km.
Por outro lado, clusters de grande escala normalmente envolvem a implantação mista de equipamentos de vários fornecedores, impondo maiores exigências à interoperabilidade. Módulos ópticos DSP baseados em protocolos padrão (como IEEE 802.3) são mais maduros em compatibilidade entre fornecedores, enquanto os padrões LPO/NPO ainda estão evoluindo, e o ecossistema ainda não está totalmente unificado.
No geral, os dois caminhos técnicos ficaram claros: Scale-Up geralmente usa LPO/NPO para alcançar menor latência e consumo de energia. Scale-Out continua a depender da arquitetura DSP para garantir transmissão de longa distância e compatibilidade do sistema. Apesar de seus diferentes métodos de implementação, ambos compartilham o mesmo objetivo na evolução da largura de banda—avançar para velocidades de 224G em canal único.
Os desafios reais da integração e implementação: oportunidades e limitações coexistem
Quando a alta confiabilidade do scale-up e a escalabilidade em larga escala do scale-out começam a se intersectar, a direção das "redes convergentes" parece natural. No entanto, ainda há vários obstáculos inevitáveis entre a experimentação e a implantação em larga escala.
Diferenças arquiteturais: dificuldade em unificar semânticas de memória e semânticas de mensagens
Os dois sistemas operam em níveis diferentes. Scale-Up é como "semântica de memória", que é uma forma de as GPUs acessarem recursos remotos. Isso faz com que todos os dispositivos possam se comunicar rapidamente entre si. Scale-Out, por outro lado, é construído com base em "semântica de mensagens", usando mecanismos como RDMA para enviar e receber dados. É basicamente um modelo de comunicação explícito. As principais diferenças na forma como eles projetam e constroem seus sistemas significam que integrá-los é mais complicado do que apenas garantir que todos possam se comunicar entre si.
Caminhos de confiabilidade inconsistentes: como introduzir links estáveis
Para garantir que um projeto seja confiável, o Scale-Up normalmente usa uma "backplane de cabos + estrutura de comutação" para reduzir o risco de falhas de link e manter o caminho crítico dentro de uma faixa de alta estabilidade. Em contraste, os sistemas Scale-Out geralmente usam módulos ópticos para interconexão. Para alcançar a convergência, parte do tráfego Scale-Out precisa ser desviada para os links altamente confiáveis do Scale-Up, exigindo a reconstrução da topologia de rede existente. Para clusters com dezenas de milhares ou até centenas de milhares de placas, esses ajustes são projetos de engenharia inerentemente complexos.
Colaboração entre fornecedores: padrões e ecossistemas permanecem fragmentados
As redes convergentes não são apenas uma questão arquitetural; elas também envolvem colaboração do setor. É necessário um alinhamento mais estreito de padrões entre chips de comutação, GPUs e módulos ópticos. Por exemplo, soluções relacionadas a LPO ainda dependem do refinamento de especificações unificadas para interoperabilidade entre fornecedores. Simultaneamente, estruturas de comutação baseadas em memória precisam se adaptar às implementações de interface de diferentes fornecedores de GPU. Atualmente, os principais fornecedores se concentram principalmente em seus próprios ecossistemas, e os protocolos e caminhos de implementação não estão totalmente unificados, o que desacelerou, em certa medida, o ritmo da convergência.
Em torno dessas questões, algumas perguntas-chave estão surgindo: o LPO tem a oportunidade de alcançar um avanço em interoperabilidade e se tornar uma solução de interconexão óptica mais universal? A semântica de memória e a semântica de mensagens podem ser integradas no nível de software para permitir que o sistema alcance tanto baixa latência quanto alta escalabilidade?
O que é certo é que a competição por infraestrutura de computação entrou em uma fase mais profunda. Cada ajuste na tecnologia de módulos ópticos, na estrutura de rede e nos métodos de colaboração do setor afetará o resultado. Em vez de simplesmente escolher entre dois caminhos, uma direção mais realista pode ser permitir que diferentes sistemas operem de forma colaborativa dentro da mesma infraestrutura. Em linha com essa tendência, ideias semelhantes a "Scale-Across" também foram propostas como uma forma de transição que conecta os dois modos.


Compartilhar
