


Rumo à arquitetura Rubin: o salto das redes de data centers de IA de 800G para 1.6T
Autor Leslie
Data 04/02/2026

A plataforma de GPU Rubin de próxima geração da NVIDIA está impulsionando uma mudança fundamental no design da infraestrutura de IA. À medida que as cargas de trabalho de IA crescem de bilhões de parâmetros para trilhões, os desafios vão muito além do desempenho computacional. O que realmente determina a eficiência do sistema costuma ser a capacidade de mover dados com eficiência entre milhares de GPUs. Nesse contexto, a rede não é mais apenas uma camada de suporte, mas um componente central que determina o desempenho da IA. Esses sistemas são projetados inerentemente para paralelismo massivo, com comunicação contínua e intensiva entre nós, remodelando assim a lógica de design dos data centers.
O que é a arquitetura Rubin
A arquitetura Rubin da NVIDIA é uma evolução da arquitetura Blackwell. É uma plataforma de computação colaborativa full-stack projetada especificamente para treinamento de modelos de IA em escala ultragrande e inferência de baixa latência. Composta por vários novos chips, ela oferece maior desempenho e eficiência energética, apoiando a operação eficiente de tarefas de IA em larga escala e servindo como infraestrutura central que impulsiona o desenvolvimento em larga escala da IA.
Ao contrário das GPUs anteriores, que se concentravam principalmente em melhorar o desempenho de um único chip, Rubin foi projetado desde o início para sistemas de IA distribuídos em larga escala. Seu objetivo final é alcançar treinamento eficiente em clusters contendo dezenas de milhares de GPUs.
Nesse ambiente, as GPUs precisam trocar continuamente gradientes, parâmetros e dados intermediários. A carga de comunicação é extremamente pesada, e a eficiência da transmissão de dados impacta diretamente a velocidade de treinamento. Embora tecnologias como InfiniBand e RDMA possam reduzir a latência e aumentar a taxa de transferência, elas ainda dependem de largura de banda suficiente na camada física.
O papel do 800G na infraestrutura de IA
A interconexão 800G tornou-se gradualmente o padrão de facto para infraestrutura de IA de alto desempenho. Em comparação com as soluções 400G, o 800G alcança o dobro da largura de banda, mantendo um equilíbrio razoável entre consumo de energia e complexidade de implantação nesta fase.
Em implantações reais, soluções 800G apresentam uma clara divisão de trabalho com base em cenários de aplicação:
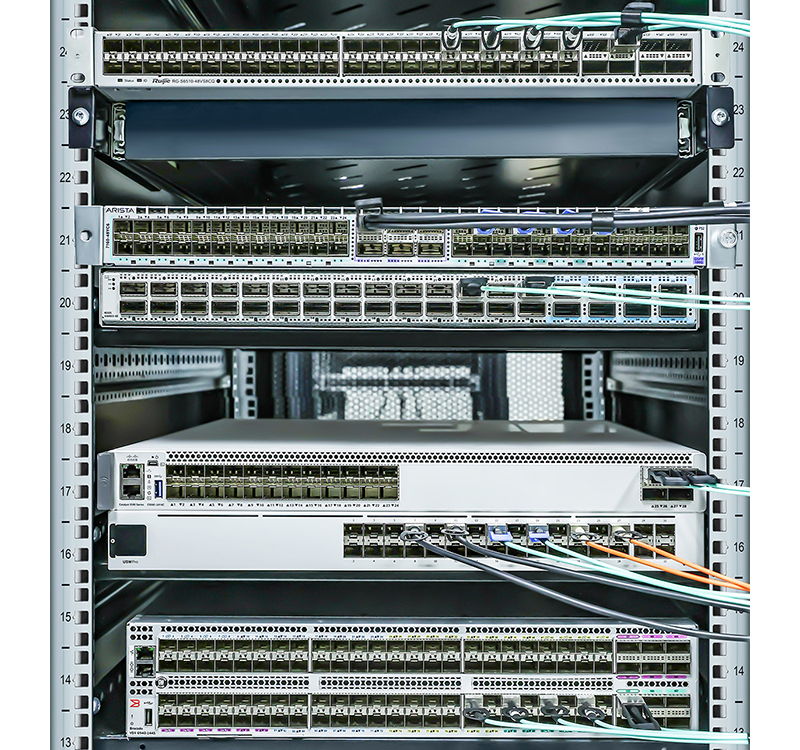
DACs são usados para conexões de distância ultracurta entre GPUs e switches ToR dentro de um rack de servidor. O cabeamento de cobre praticamente não introduz consumo adicional de energia e tem a menor latência de transmissão, tornando-o o meio preferido para interconexões de alta densidade dentro de racks de servidores.
AOCs são adequados para conexões de curta a média distância entre racks de servidores. AOCs integram módulos ópticos e cabos, simplificando o processo de implantação no local, ao mesmo tempo em que garantem a integridade do sinal e reduzem os requisitos de limpeza e manutenção das interfaces de fibra óptica.
Módulos ópticos são usados na camada principal de backbone de redes estruturadas, oferecendo suporte a interconexões de longa distância em arquiteturas Spine-Leaf. Módulos ópticos, em conjunto com sistemas de cabeamento de fibra óptica, permitem a expansão da rede entre PODs e regiões.
Essa abordagem de implantação em camadas reflete as necessidades reais de engenharia de clusters de IA em larga escala. Tomando a QSFPTEK como exemplo, sua linha de produtos 800G cobre toda a gama de DACs, AOCs e módulos ópticos. Seu valor central está em garantir que os usuários obtenham desempenho de compatibilidade consistente em uma arquitetura de rede de três camadas. Em ambientes de clusters de IA de alta densidade e alto rendimento, a interoperabilidade estável entre cenários costuma ser mais significativa do que um único indicador de desempenho.
As limitações do 800G na era Rubin
Embora as soluções 800G tenham sido bem comprovadas nos clusters de IA atuais, suas limitações estão se tornando cada vez mais aparentes ao enfrentar a densidade de computação de próxima geração representada pela arquitetura NVIDIA Rubin.
As principais fontes de pressão são os três aspectos a seguir:
Densidade de GPU em Rápida Ascensão: O número de GPUs por rack está evoluindo do padrão atual de 8 para 16 ou 32, e a demanda agregada de largura de banda dentro do rack está saltando do nível de Tbps para dezenas de Tbps, representando um desafio severo para a taxa de convergência das portas dos switches ToR.
Expansão do tamanho do cluster: Os nós de cluster estão se expandindo de milhares para dezenas de milhares ou até centenas de milhares de nós, e o padrão de congestionamento da rede está evoluindo de pontos de acesso locais para congestionamento distribuído globalmente. Simplesmente aumentar o número de links levará a um aumento superlinear na complexidade do cabeamento, no consumo de energia e nos custos de manutenção;
Evolução dos modos de comunicação: Novas estratégias de paralelismo de modelos, representadas pelo Paralelismo de Especialistas (MoE), aumentam significativamente a frequência de sincronização entre GPUs em comparação com a arquitetura Transformer tradicional, exigindo que o sistema de rede atenda simultaneamente aos requisitos combinados de alta largura de banda e baixa latência.
Do ponto de vista da relação de correspondência entre computação e rede, espera-se que a taxa de transferência de computação de uma única placa da plataforma Rubin seja mais que o dobro da arquitetura Blackwell. Se a largura de banda da rede permanecer inalterada, a proporção de tempo ocioso dos recursos de computação aguardando dados aumentará significativamente, limitando diretamente a utilização efetiva do poder de computação da GPU.
Por que os módulos 1.6T são necessários
O avanço da interconexão 1.6T é impulsionado em grande parte pela demanda rígida por largura de banda de rede das arquiteturas de GPU de próxima geração. Sua importância reside não apenas em dobrar as velocidades das portas, mas também em fornecer um caminho técnico viável para resolver os gargalos estruturais mencionados anteriormente.
O valor central de 1.6T se reflete nas seguintes dimensões:
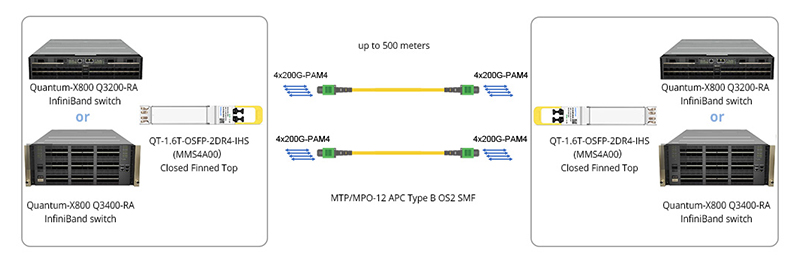
Maior densidade de largura de banda: Uma única porta fornece 200GB/s de taxa de transferência de dados. Por exemplo, um switch de 48 portas pode fornecer quase 10Tbps de largura de banda agregada, reduzindo o número de portas e o espaço ocupado no rack em cerca de metade em comparação com soluções 800G;
Topologia Simplificada: Com o mesmo tamanho de cluster, 1.6T suporta uma topologia de rede mais plana, como simplificar uma arquitetura Clos de três níveis para uma arquitetura de dois níveis, reduzindo o número de dispositivos da camada Spine e, ao mesmo tempo, reduzindo o acúmulo de latência causado pelo encaminhamento entre camadas.
Complexidade operacional reduzida: A redução no número de links leva diretamente a uma diminuição simultânea no número de núcleos de fibra, módulos ópticos e pontos de falha. Em clusters de grande escala, esse efeito pode se traduzir em uma melhoria considerável na eficiência operacional.
A QSFPTEK já iniciou sua implantação tecnológica na linha de produtos 1.6T, oferecendo vários módulos 1.6T para data centers de IA. Isso significa que eles podem planejar proativamente a integração de redes de próxima geração na infraestrutura 800G existente, em vez de enfrentar a pressão de atualizações reativas durante a implantação completa da arquitetura Rubin.
Caminho real de atualização recomendado
A evolução de 800G para 1.6T em ambientes reais de data center normalmente segue um caminho gradual, em vez de uma substituição completa de uma só vez.
Você pode consultar o seguinte caminho de atualização:
Camada de acesso e interconexões de curto alcance: continue usando as soluções DAC e AOC 800G. As vantagens do cabeamento de cobre e dos cabos ópticos ativos em termos de consumo de energia e custo continuam difíceis de substituir no curto prazo em cenários de curto alcance dentro dos racks e entre eles;
Camada Spine e backbone central: Introduza primeiro módulos ópticos e switches 1.6T para transportar tráfego agregado entre PODs, reservando margem de largura de banda suficiente para que a camada central acomode necessidades futuras de expansão;
Transição para arquitetura híbrida: obtenha operação híbrida de equipamentos 800G e 1.6T por meio de agregação de links ou mecanismos de negociação de taxa, concluindo gradualmente a substituição geracional da camada de acesso à camada de núcleo, evitando despesas de capital únicas e riscos de interrupção de serviço.
Para data centers que já implantaram infraestrutura 800G, normalmente é adotado um período de transição suave de 2 a 3 anos. Durante esse período, é necessário prestar atenção simultaneamente à compatibilidade retroativa dos módulos ópticos, à capacidade reservada do sistema de cabeamento e às capacidades de coordenação multirrate do sistema operacional de rede.
Conclusão
A transição de módulos ópticos 800G para 1.6T é essencial para dar suporte à arquitetura Rubin da NVIDIA. 1.6T oferece maior densidade de largura de banda, estrutura de rede mais simples e menor latência para atender às demandas dos data centers de próxima geração. Com uma abordagem de atualização em fases, os usuários podem fazer a transição de sua infraestrutura de forma tranquila, aproveitando ao máximo as soluções ópticas 1.6T da QSFPTEK para conectividade de cluster estável e de alto desempenho.


Compartilhar
