


Vers l’architecture Rubin : Le bond des réseaux de centres de données IA de 800G à 1.6T
Auteur Leslie
Date 04/02/2026

La plateforme GPU Rubin de nouvelle génération de NVIDIA entraîne une transformation fondamentale de la conception des infrastructures d’IA. À mesure que les charges de travail d’IA passent de milliards à des milliers de milliards de paramètres, les défis vont bien au-delà des performances de calcul. Ce qui détermine véritablement l’efficacité du système est souvent la capacité à déplacer efficacement les données entre des milliers de GPU. Dans ce contexte, le réseau n’est plus seulement une couche de support, mais un composant central qui détermine les performances de l’IA. Ces systèmes sont intrinsèquement conçus pour un parallélisme massif, avec une communication continue et intensive entre les nœuds, remodelant ainsi la logique de conception des centres de données.
Qu’est-ce que l’architecture Rubin
L'architecture Rubin de NVIDIA est une évolution de l'architecture Blackwell. Il s'agit d'une plateforme informatique collaborative full-stack spécialement conçue pour l'entraînement de modèles d'IA à très grande échelle et l'inférence à faible latence. Composée de plusieurs nouvelles puces, elle offre des performances et une efficacité énergétique supérieures, prend en charge l'exécution efficace des tâches d'IA à grande échelle et sert d'infrastructure de base pour stimuler le développement à grande échelle de l'IA.
Contrairement aux GPU précédents, qui se concentraient principalement sur l’amélioration des performances d’une seule puce, Rubin a été conçu dès le départ pour les systèmes d’IA distribués à grande échelle. Son objectif ultime est de permettre un entraînement efficace sur des clusters contenant des dizaines de milliers de GPU.
Dans cet environnement, les GPU doivent échanger en continu des gradients, des paramètres et des données intermédiaires. La charge de communication est extrêmement lourde, et l’efficacité de la transmission des données a un impact direct sur la vitesse d’entraînement. Bien que des technologies comme InfiniBand et RDMA puissent réduire la latence et augmenter le débit, elles dépendent toujours d’une bande passante suffisante au niveau de la couche physique.
Le rôle du 800G dans l’infrastructure d’IA
L’interconnexion 800G est progressivement devenue la norme de facto pour les infrastructures d’IA hautes performances. Par rapport aux solutions 400G, le 800G offre une bande passante deux fois supérieure tout en assurant un équilibre raisonnable entre consommation d’énergie et complexité de déploiement à ce stade.
Dans les déploiements réels, Solutions 800G présentent une répartition claire du travail selon les scénarios d’application :
Les DAC sont utilisés pour les connexions à très courte distance entre les GPU et les commutateurs ToR au sein d’une baie de serveurs. Le câblage en cuivre n’entraîne pratiquement aucune consommation d’énergie supplémentaire et présente la latence de transmission la plus faible, ce qui en fait le support privilégié pour les interconnexions haute densité au sein des baies de serveurs.
Les AOC conviennent aux connexions de courte à moyenne distance entre les racks de serveurs. Les AOC intègrent des modules optiques et des câbles, simplifiant le processus de déploiement sur site tout en garantissant l’intégrité du signal et en réduisant les exigences de nettoyage et de maintenance des interfaces à fibre optique.
Les modules optiques sont utilisés dans la couche cœur de backbone des réseaux structurés, prenant en charge les interconnexions longue distance dans les architectures Spine-Leaf. Les modules optiques, associés aux systèmes de câblage à fibre optique, permettent l’extension du réseau entre les POD et les régions.
Cette approche de déploiement en couches reflète les besoins réels d’ingénierie des clusters d’IA à grande échelle. En prenant QSFPTEK comme exemple, sa gamme de produits 800G couvre l’ensemble des DAC, des AOC et des modules optiques. Sa valeur essentielle réside dans le fait de garantir aux utilisateurs des performances de compatibilité constantes dans une architecture réseau à trois couches. Dans les environnements de clusters d’IA haute densité et haut débit, une interopérabilité stable entre différents scénarios est souvent plus significative qu’un seul indicateur de performance.
Les limites du 800G à l’ère Rubin
Bien que les solutions 800G aient fait leurs preuves dans les clusters d’IA actuels, leurs limites deviennent de plus en plus apparentes face à la densité de calcul de nouvelle génération représentée par l’architecture NVIDIA Rubin.
Les principales sources de pression sont les trois aspects suivants :
Densité de GPU en forte hausse: Le nombre de GPU par rack évolue de la norme actuelle de 8 vers 16 ou 32, et la demande de bande passante agrégée au sein du rack bondit du niveau Tbps à des dizaines de Tbps, posant un défi majeur au taux de convergence des ports des commutateurs ToR.
Extension de la taille du cluster: Les nœuds de cluster passent de milliers à des dizaines de milliers, voire des centaines de milliers de nœuds, et le schéma de congestion du réseau évolue de points chauds locaux vers une congestion distribuée à l’échelle mondiale. Le simple fait d’augmenter le nombre de liaisons entraînera une augmentation superlinéaire de la complexité du câblage, de la consommation d’énergie et des coûts de maintenance;
Évolution des modes de communication: Les nouvelles stratégies de parallélisme de modèle, représentées par le parallélisme d’experts (MoE), augmentent considérablement la fréquence de synchronisation entre les GPU par rapport à l’architecture Transformer traditionnelle, ce qui oblige le système réseau à répondre simultanément aux exigences combinées de bande passante élevée et de faible latence.
Du point de vue de la relation de correspondance entre le calcul et le réseau, le débit de calcul d’une seule carte de la plateforme Rubin devrait être plus de deux fois supérieur à celui de l’architecture Blackwell. Si la bande passante réseau reste inchangée, la proportion de temps d’inactivité des ressources de calcul en attente de données augmentera considérablement, limitant directement l’utilisation effective de la puissance de calcul des GPU.
Pourquoi les modules 1.6T sont-ils nécessaires
Le progrès de l’interconnexion 1.6T est largement porté par la demande rigide en bande passante réseau des architectures GPU de nouvelle génération. Son importance ne réside pas seulement dans le doublement des débits des ports, mais aussi dans la fourniture d’une voie technique viable pour remédier aux goulets d’étranglement structurels susmentionnés.
La valeur fondamentale de 1.6T se reflète dans les dimensions suivantes :
Densité de bande passante accrue: Un seul port offre un débit de données de 200GB/s. Par exemple, un commutateur à 48 ports peut fournir près de 10Tbps de bande passante agrégée, réduisant d'environ moitié le nombre de ports et l'espace rack occupé par rapport aux solutions 800G;
Topologie simplifiée: À taille de cluster identique, 1.6T prend en charge une topologie réseau plus plate, par exemple en simplifiant une architecture Clos à trois niveaux en une architecture à deux niveaux, en réduisant le nombre d’appareils de couche Spine et en réduisant simultanément l’accumulation de latence causée par le transfert inter-couches.
Complexité opérationnelle réduite: La réduction du nombre de liaisons entraîne directement une diminution simultanée du nombre de cœurs de fibre, de modules optiques et de points de défaillance. Dans les clusters à grande échelle, cet effet peut se traduire par une amélioration considérable de l’efficacité opérationnelle.
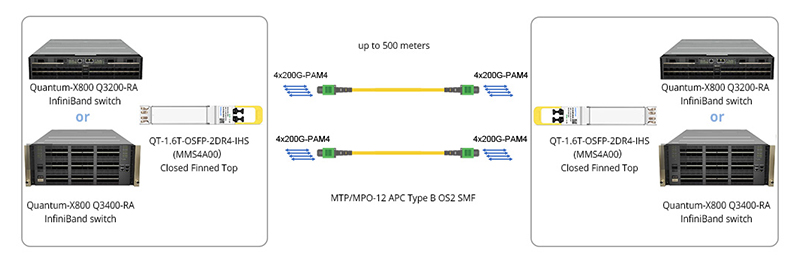
QSFPTEK a déjà commencé le déploiement de sa technologie dans la gamme de produits 1.6T, proposant plusieurs Modules 1.6T pour les centres de données IA. Cela signifie qu’ils peuvent planifier de manière proactive l’intégration des réseaux de prochaine génération sur l’infrastructure 800G existante, plutôt que de subir la pression de mises à niveau réactives lors du déploiement complet de l’architecture Rubin.
Chemin de mise à niveau réel recommandé
L’évolution de 800G à 1.6T dans les environnements de centres de données réels suit généralement une trajectoire progressive, plutôt qu’un remplacement complet en une seule fois.
Vous pouvez vous référer au chemin de mise à niveau suivant :
Couche d’accès et interconnexions à courte portée : continuez à utiliser les solutions 800G DAC et AOC. Les avantages du câblage en cuivre et des câbles optiques actifs en termes de consommation d’énergie et de coût restent difficiles à remplacer à court terme pour les scénarios à courte portée au sein des baies et entre elles ;
Couche spine et cœur de réseau : introduire d’abord des modules optiques et des commutateurs 1.6T pour transporter le trafic agrégé entre les PODs, en réservant une marge de bande passante suffisante pour que la couche cœur réponde aux besoins d’expansion futurs ;
Transition vers une architecture hybride : réalisez l’exploitation hybride d’équipements 800G et 1.6T grâce à des mécanismes d’agrégation de liens ou de négociation de débit, en achevant progressivement le remplacement générationnel de la couche d’accès à la couche cœur, tout en évitant les dépenses d’investissement ponctuelles et les risques d’interruption de service.
Pour les centres de données qui ont déjà déployé une infrastructure 800G, une période de transition progressive de 2 à 3 ans est généralement adoptée. Pendant cette période, il est nécessaire de prêter simultanément attention à la rétrocompatibilité des modules optiques, à la capacité réservée du système de câblage et aux capacités de coordination multi-débits du système d’exploitation réseau.
Conclusion
Le passage des modules optiques 800G aux modules optiques 1.6T est essentiel pour prendre en charge l’architecture Rubin de NVIDIA’. Le 1.6T offre une densité de bande passante plus élevée, une structure réseau plus simple et une latence réduite afin de répondre aux exigences des centres de données de nouvelle génération. Grâce à une approche de mise à niveau par étapes, les utilisateurs peuvent faire évoluer progressivement leur infrastructure tout en tirant pleinement parti des solutions optiques 1.6T de QSFPTEK’ pour une connectivité de cluster stable et haute performance.


Partager
